چطور فایل robots.txt بسازیم؟ راهنمای استفاده از ابزار هیس
با ابزار robots.txt هیس برای خزندهها قواعد Allow و Disallow بسازید، نشانی sitemap را اضافه کنید و پیش از استفاده، خطاهای رایج و نکات ایمنی را بشناسید.
چطور فایل robots.txt بسازیم؟ راهنمای استفاده از ابزار هیس
با ابزار robots.txt هیس برای خزندهها قواعد Allow و Disallow بسازید، نشانی sitemap را اضافه کنید و پیش از استفاده، خطاهای رایج و نکات ایمنی را بشناسید.
فهرست مطالب
- robots.txt چیست و چه کاری انجام میدهد؟
- تفاوت خزش، ایندکس و دسترسی خصوصی
- فایل کجا قرار میگیرد و هر قاعده چه محدودهای دارد؟
- چطور با ابزار هیس فایل robots.txt بسازیم؟
- قبل از جایگزینکردن فایل فعلی چه چیزهایی را بررسی کنیم؟
- اشتباههای رایج در نوشتن robots.txt
- مسدودکردن همهی سایت
- استفاده از robots.txt برای پنهانکردن اطلاعات
- تصور اینکه Disallow صفحه را از گوگل حذف میکند
- بستن CSS، JavaScript یا مسیر موردنیاز صفحه
- نادیدهگرفتن مسیرها و ترتیب قواعد
- چکلیست کوتاه پیش از اعمال فایل
- پرسشهای متداول
- آیا هر سایت به فایل robots.txt نیاز دارد؟
- آیا میتوان چند نشانی sitemap در فایل گذاشت؟
- آیا قاعدهی robots.txt همهی رباتها را متوقف میکند؟
- ابزار هیس فایل را روی سایت منتشر میکند؟
- جمعبندی
اگر صفحههای فیلتر فروشگاه، نتایج جستوجوی داخلی یا مسیرهای آزمایشی زیادی دارید، شاید نخواهید خزندهها همهی آنها را مرتب بررسی کنند. فایل robots.txt راهی برای اعلام ترجیح شما دربارهی دسترسی خزندهها به مسیرهای سایت است. برای ساخت این فایل لازم نیست از صفحهی سفید شروع کنید؛ در این راهنما با قواعد اصلی و روش استفاده از ابزار سازندهی robots.txt هیس آشنا میشوید.
robots.txt چیست و چه کاری انجام میدهد؟
robots.txt یک فایل متنی در ریشهی سایت است که به خزندهها میگوید کدام مسیرها را میتوانند درخواست کنند و کدام مسیرها را نباید بخزند. این فایل برای مدیریت خزش به کار میرود؛ یعنی کنترل درخواست خزندهها به بخشهایی از سایت، نه قفلکردن آن بخشها.
این تفاوت مهم است: robots.txt از اطلاعات خصوصی محافظت نمیکند. فایل خودش عمومی است و خزندههای غیرمتعهد هم ممکن است دستورهایش را نادیده بگیرند. اگر محتوایی باید فقط برای افراد مجاز قابلدسترسی باشد، آن را با احراز هویت و کنترل دسترسی محافظت کنید. مستندات گوگل دربارهی robots.txt نیز هشدار میدهد که این فایل ابزار پنهانکردن صفحه از نتایج جستوجو نیست.
تفاوت خزش، ایندکس و دسترسی خصوصی
خزش زمانی است که ربات صفحه را درخواست و محتوایش را دریافت میکند. ایندکس یعنی موتور جستوجو تصمیم میگیرد صفحه را در پایگاه خود نگه دارد و امکان نمایش آن را در نتیجهها بررسی کند. این دو مرحله به هم مرتبطاند، اما یکی نیستند.
اگر صفحهای را در robots.txt مسدود کنید، گوگل ممکن است نتواند محتوای آن را بخواند؛ بااینحال، اگر نشانی صفحه از جای دیگری شناخته شود، URL آن هنوز ممکن است بدون توضیح متنی در نتایج دیده شود. برای جلوگیری از ایندکسشدن صفحه، از روشهایی مانند دستور noindex استفاده میشود و صفحه باید برای خزنده قابلدسترسی باشد تا آن دستور را ببیند. نوشتن noindex در robots.txt پشتیبانی نمیشود. برای اطلاعات خصوصی هم راه درست، محدودکردن دسترسی با رمز و مجوز است، نه robots.txt. جزئیات را در راهنمای گوگل دربارهی noindex بخوانید.
فایل کجا قرار میگیرد و هر قاعده چه محدودهای دارد؟
فایل باید در مسیر ریشهی همان سایت قرار بگیرد؛ برای نمونه، نشانی آن میشود https://example.com/robots.txt. قواعد فایل به همان میزبان، پروتکل و پورت مربوطاند. بنابراین فایل دامنهی اصلی بهطور خودکار قانون دامنهی زیردامنه را تعیین نمیکند؛ برای نمونه، shop.example.com/robots.txt میتواند robots.txt جداگانهای داشته باشد.
سه بخش پرکاربرد فایل اینها هستند:
User-agent گروه قواعد را برای خزنده مشخص میکند. در Google، قواعد گروهی اعمال میشوند که مقدار User-agent آن اختصاصیترین تطبیق را با خزنده داشته باشد؛ اگر گروه اختصاصیتری وجود نداشته باشد، گروه * به کار میرود.
Disallow مسیرهایی را مشخص میکند که خزندهی هدف نباید درخواست کند.
Allow مسیری را برای خزش مجاز میکند. در Google، برای هر URL قاعدهی منطبق با مسیر مشخصتر (مسیر طولانیتر) اعمال میشود؛ اگر دو قاعدهی متناقض مسیر هماندازهای داشته باشند، قاعدهی کممحدودکنندهتر، یعنی Allow، اولویت دارد. رفتار خزندههای دیگر ممکن است متفاوت باشد.
نمونهی زیر فقط برای توضیح ساختار است؛ مسیرها را با نیاز واقعی سایت خودتان عوض کنید:
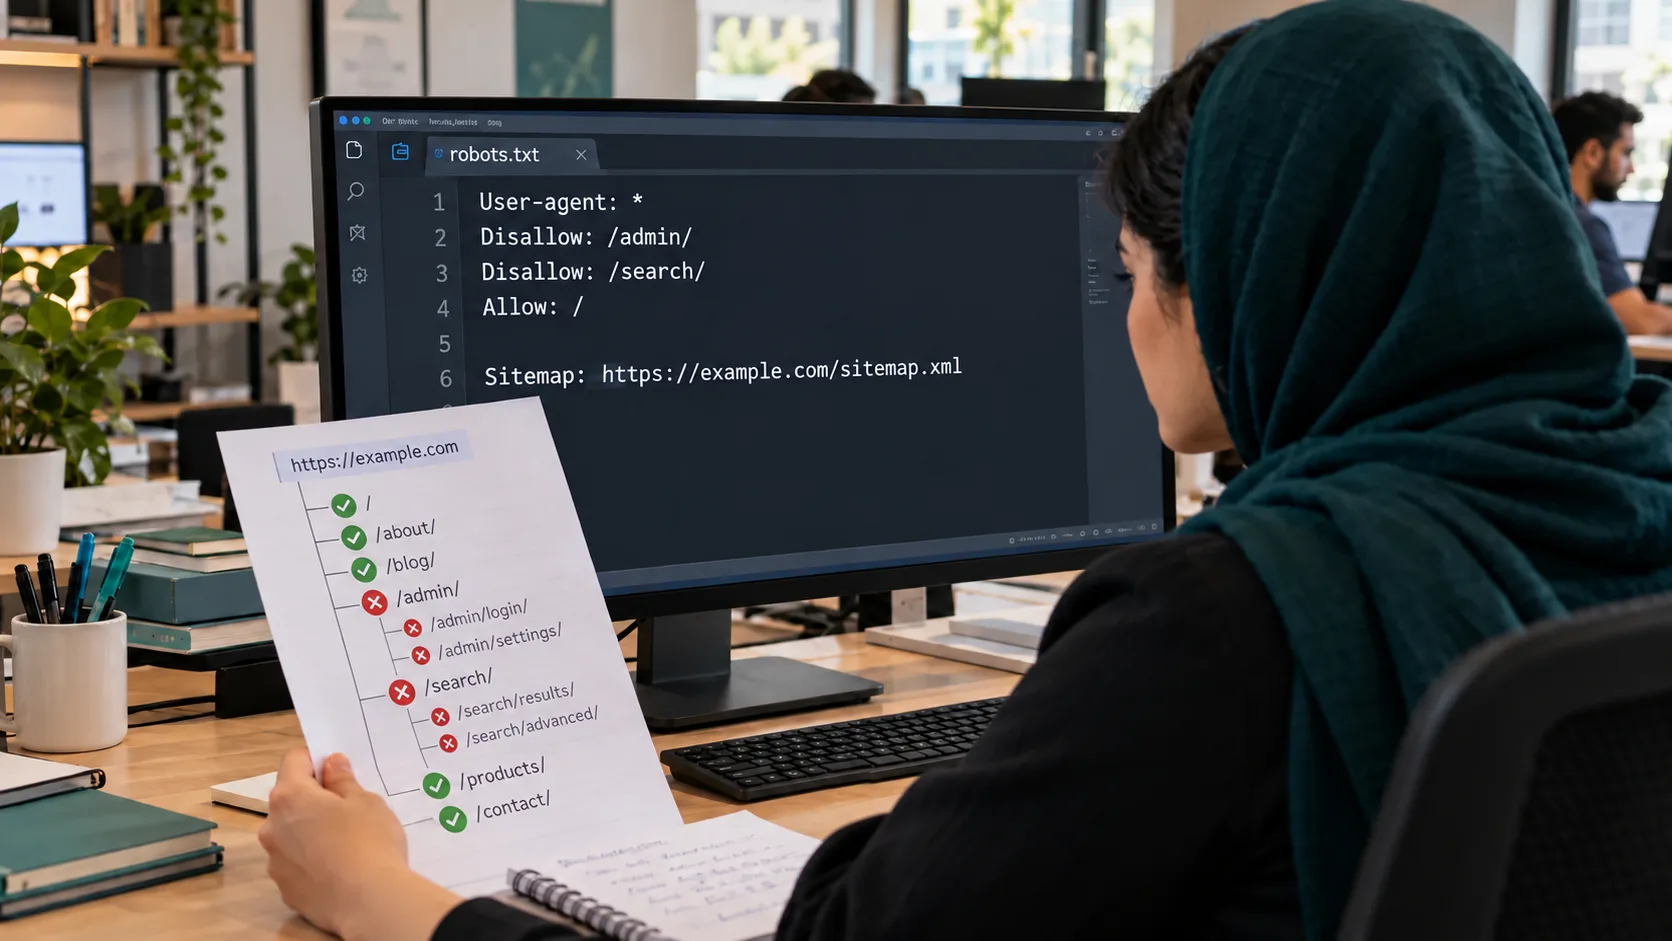
User-agent: *
Disallow: /private-area/
Sitemap: https://example.com/sitemap.xml
علامت / ابتدای مسیر، آن را از ریشهی سایت مشخص میکند. اسلش پایانی هم کمک میکند منظور پوشهی /private-area/ باشد. از قواعد عامتر، الگوها و چند گروه User-agent هم میتوان استفاده کرد، اما اگر نیازی به آنها ندارید، فایل سادهتر و روشنتر را نگه دارید. مشخصات رفتار گوگل را در مستندات رسمی تفسیر robots.txt ببینید.
فایل robots.txt باید متن ساده با کدگذاری UTF-8 باشد. Google محتوای این فایل را تا سقف ۵۰۰ کیبیبایت پردازش میکند و بخشهای پس از این حد را نادیده میگیرد؛ بنابراین قواعد غیرضروری را در فایل انباشته نکنید.
چطور با ابزار هیس فایل robots.txt بسازیم؟
ابزار سازندهی robots.txt هیس برای ساخت متن اولیه طراحی شده است. در ابزار، دامنهی سایت را وارد میکنید، برای هر مسیر دستور Allow یا Disallow را برمیگزینید، در صورت نیاز قاعدهی دیگری میافزایید و مشخص میکنید نشانی sitemap در خروجی بیاید یا نه. سپس متن ساختهشده را بررسی و کپی میکنید.
نشانی دامنه را وارد کنید. دامنهای را بنویسید که فایل قرار است برای همان میزبان استفاده شود. اگر sitemap را در خروجی میخواهید، نشانی کامل و درست آن را بررسی کنید.
مسیرهای لازم را اضافه یا اصلاح کنید. مسیر باید از اسلش شروع شود؛ مثلاً /search/. برای هر ردیف، تصمیم بگیرید خزنده اجازهی دسترسی داشته باشد یا نه.
نمونههای اولیه را با دقت بازبینی کنید. ابزار در شروع دو مسیر نمونهی /admin/ و /api/ نشان میدهد. اینها قانون مناسب همهی سایتها نیستند.
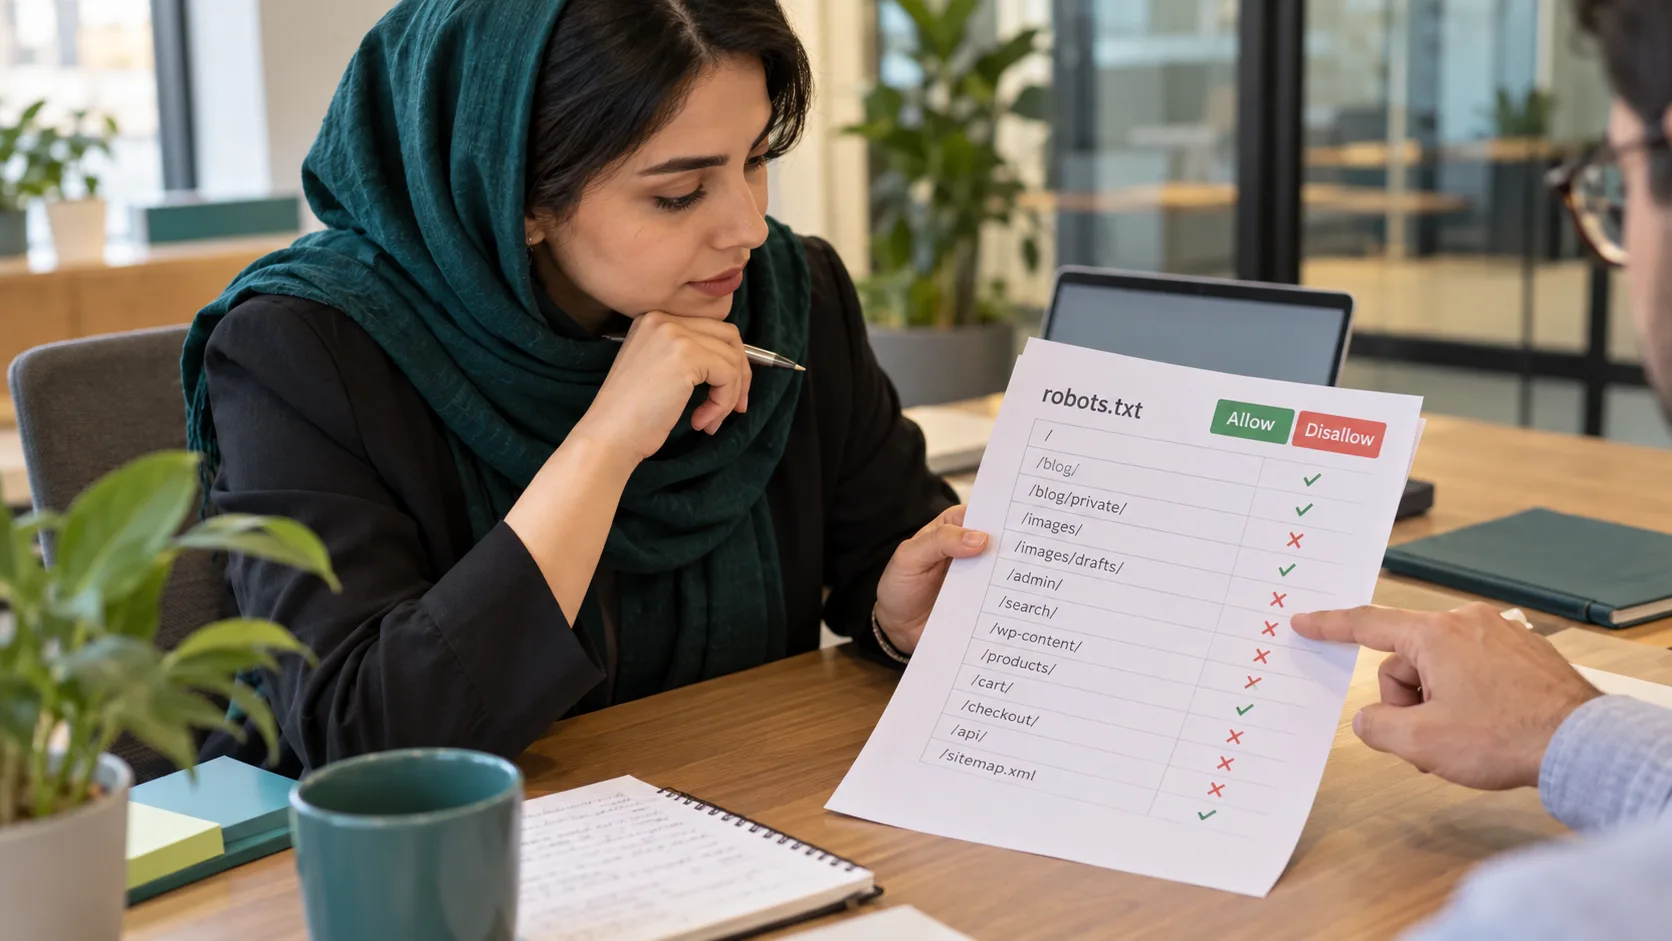
اگر بخشی از API برای بارگذاری یا فهم محتوای صفحه لازم باشد، بستن آن میتواند در دسترسی خزنده به منابع موردنیاز اختلال ایجاد کند. هر مسیر را بر اساس ساختار واقعی سایت ارزیابی کنید و قاعدهی غیرضروری را حذف یا اصلاح کنید.
افزودن sitemap را بررسی کنید. اگر گزینه را فعال میگذارید، مطمئن شوید sitemap در همان نشانی درجشده واقعاً در دسترس است. سطر sitemap فقط نشانی نقشهی سایت را به خزنده معرفی میکند و تضمین نمیکند همهی URLها خزش یا ایندکس شوند.
خروجی را پیش از استفاده بخوانید. مطمئن شوید دستور ناخواستهای برای مسیرهای مهم وجود ندارد و بهاشتباه از Disallow: / برای بستن همهی سایت استفاده نکردهاید. سپس متن را کپی کنید.
قبل از جایگزینکردن فایل فعلی چه چیزهایی را بررسی کنیم؟
اگر سایت از قبل robots.txt دارد، ابتدا نشانی https://example.com/robots.txt را باز کنید و نسخهی فعلی را بخوانید. فایل تازهای که از ابزار میگیرید لزوماً همهی تنظیمات موجود را در بر ندارد. پس خروجی را بیبررسی روی فایل قبلی ننویسید؛ قواعد لازم، گروههای خزنده و نشانیهای sitemap را حفظ یا آگاهانه اصلاح کنید.
همچنین ببینید فایل از کجا مدیریت میشود. بعضی سیستمهای مدیریت محتوا یا سرویسهای میزبانی، robots.txt را خودکار میسازند و تنظیم مستقل دارند. در چنین حالتی تغییر از مسیر نامناسب ممکن است با نسخهی خودکار تعارض پیدا کند یا در انتشار بعدی بازنویسی شود. متن تولیدشدهی ابزار بهتنهایی روی سایت اعمال نمیشود؛ باید آن را با روش سازگار با CMS یا میزبانی خود در مسیر ریشه قرار دهید.
پس از اعمال تغییر، URL عمومی robots.txt را دوباره باز کنید و مطمئن شوید همان نسخهی موردنظر پاسخ داده میشود. بعد مسیرهای مهم را با ابزارهای بررسی سایت و گزارشهای دسترسی خزنده مرور کنید. برای ارزیابی کلی وضعیت فنی میتوانید از راهنمای ممیزی فنی سئو کمک بگیرید.
اشتباههای رایج در نوشتن robots.txt
مسدودکردن همهی سایت
قاعدهی Disallow: / برای همهی خزندههای گروه مربوط، تمام مسیرهای سایت را میبندد. ممکن است در محیط آزمایشی کاربرد داشته باشد، اما اگر تصادفی در سایت اصلی منتشر شود، دسترسی خزندههای موتور جستوجو به کل سایت را محدود میکند. پس پیش از انتشار، ابتدای فایل و گروههای User-agent را دوباره بخوانید.
استفاده از robots.txt برای پنهانکردن اطلاعات
نام یک مسیر در robots.txt رازآلود نمیماند؛ هر کسی میتواند فایل را ببیند. این فایل دستور درخواستنکردن است، نه مجوز دسترسی. برای صفحههای خصوصی، احراز هویت لازم است.
تصور اینکه Disallow صفحه را از گوگل حذف میکند
مسدودکردن خزش مساوی حذف از نتایج نیست. اگر هدف این است که صفحه در نتایج جستوجو نمایش داده نشود، روش ایندکسزدایی مناسب را انتخاب کنید و ناخواسته راه خزش صفحه را هم نبندید تا ربات بتواند noindex را ببیند.
بستن CSS، JavaScript یا مسیر موردنیاز صفحه
اگر منابعی را ببندید که برای نمایش و درک صفحه لازماند، خزنده ممکن است نتواند صفحه را درست رندر کند. هر قاعده را با توجه به کاربرد مسیر بررسی کنید؛ نام یک پوشه بهتنهایی دلیل کافی برای مسدودکردن آن نیست.
نادیدهگرفتن مسیرها و ترتیب قواعد
نشانی مسیر به بزرگی و کوچکی حروف حساس است؛ /Search/ و /search/ ممکن است یکسان تطبیق داده نشوند. قواعد مشخصتر هم میتوانند نتیجهی مورد انتظار از یک قاعدهی عمومی را تغییر دهند. نمونهی نهایی را با چند URL واقعی مقایسه کنید و برای مسیرهای پرتعداد یا پارامتردار، قواعد ساده و قابلآزمون نگه دارید. اگر فروشگاه شما فیلترهای زیادی دارد، راهنمای مدیریت صفحات فیلتر فروشگاهی در سئو را هم ببینید.
چکلیست کوتاه پیش از اعمال فایل
دامنه و مسیر ریشهی فایل درست است.
مشخص است هر گروه User-agent شامل کدام قواعد میشود.
هیچ صفحه یا منبع ضروری بهطور ناخواسته مسدود نشده است.
از robots.txt برای حفاظت از اطلاعات خصوصی یا جایگزینی noindex استفاده نشده است.
نشانی sitemap کامل، درست و در دسترس است.
قواعد موجود سایت با خروجی تازه مقایسه شدهاند.
پس از اعمال، نسخهی عمومی فایل دوباره بررسی شده است.
پرسشهای متداول
آیا هر سایت به فایل robots.txt نیاز دارد؟
اگر محدودیتی برای خزش ندارید، ممکن است به قاعدهی خاصی نیاز نباشد. Google پاسخهای 4xx بهجز 429 را مانند نبودن فایل تفسیر میکند؛ در این حالت قاعدهای از robots.txt محدودیت خزش ایجاد نمیکند. خطاهای 5xx رفتار دیگری دارند: Google ممکن است خزش را موقتاً متوقف کند یا از آخرین نسخهی موفق فایل استفاده کند. پس خطای سرور را با نبودن فایل یکی نگیرید. در CMSها، روش ساخت یا ویرایش فایل را از تنظیمات همان سیستم بررسی کنید.
آیا میتوان چند نشانی sitemap در فایل گذاشت؟
بله، موتورهای جستوجوی بزرگ از سطرهای Sitemap با URL کامل پشتیبانی میکنند. نقشهی سایت راهنمایی برای کشف URLهاست و تضمین خزش یا رتبهگرفتن آنها نیست.
آیا قاعدهی robots.txt همهی رباتها را متوقف میکند؟
خیر. این پروتکل بر همکاری خزنده متکی است. رباتهای معتبر معمولاً قواعد را رعایت میکنند، اما robots.txt سد امنیتی نیست و رفتار همهی رباتها را نمیتوان با آن کنترل کرد.
ابزار هیس فایل را روی سایت منتشر میکند؟
خیر. ابزار متن robots.txt را میسازد و امکان کپی خروجی را میدهد. قرار دادن فایل در ریشهی دامنه و بررسی نسخهی منتشرشده باید از راهکار CMS یا میزبان سایت انجام شود.
جمعبندی
robots.txt برای مدیریت خزش خزندههاست؛ نه برای پنهانکردن صفحه از نتایج جستوجو و نه برای محافظت از اطلاعات خصوصی. ابزار سازندهی هیس کمک میکند قواعد Allow و Disallow و نشانی sitemap را در یک خروجی متنی کنار هم بگذارید، اما تصمیم نهایی دربارهی هر مسیر به ساختار سایت شما بستگی دارد. ابتدا فایل فعلی و مسیرهای مهم را بررسی کنید، نمونههای اولیه را بیتغییر کپی نکنید و پس از اعمال، نسخهی عمومی فایل را دوباره ببینید. برای ساخت نسخهی اولیه میتوانید از ابزار robots.txt هیس شروع کنید و فقط قواعدی را نگه دارید که هدفشان روشن است.
برای رشد کسبوکارتان آمادهاید؟
با هیس دیجیتال، مسیر مناسب رشد و بازاریابی کسبوکار خود را پیدا کنید.